數字化工廠的數據收集、處理與數據挖掘 從感知到智能決策
引言
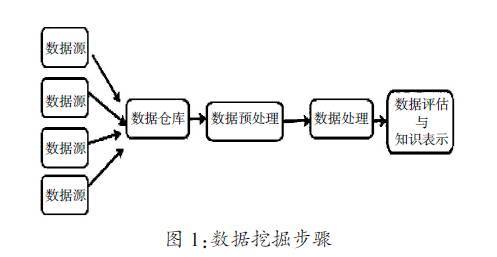
數字化工廠的核心在于將物理生產系統與數字世界深度融合,而數據是這一融合的血液。從設備運轉到質量檢測,從物料流動到人員操作,工廠每時每刻都在產生海量數據。如何高效地收集、處理這些數據,并通過數據挖掘提取價值,是實現智能制造的關鍵。本文將系統闡述數字化工廠的數據收集、處理流程以及數據挖掘的應用。
一、數據收集:構建工廠的感知神經
數字化工廠的數據收集強調“全面、實時、準確”。主要來源包括:
- 設備與傳感器數據:通過PLC、SCADA、工業物聯網(IIoT)傳感器采集溫度、壓力、振動、電流、轉速等運行參數。采用OPC UA、MQTT、Modbus等協議實現設備互聯。
- 生產與過程數據:MES(制造執行系統)記錄工單進度、產量、良率、工藝參數;QMS(質量管理系統)采集檢測結果。
- 物料與物流數據:RFID、二維碼、AGV定位系統追蹤物料批次、庫存、流轉路徑。
- 人員與環保數據:可穿戴設備、門禁系統記錄人員位置與操作;環境傳感器監測溫濕度、能耗、排放。
- 外部數據:ERP中的訂單、供應鏈信息,以及市場、天氣等輔助數據。
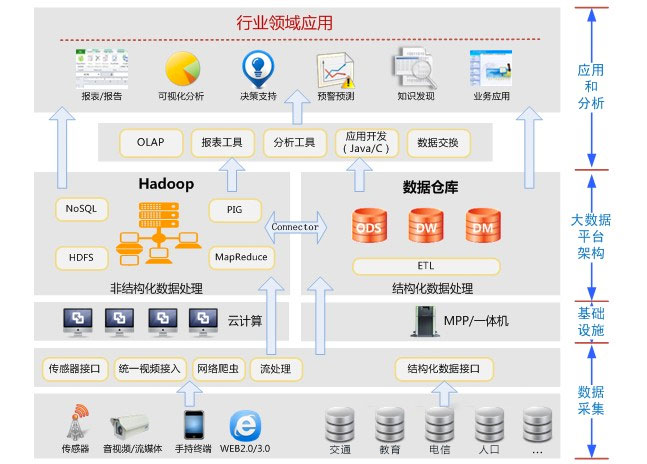
收集技術:邊緣計算網關就近采集并預處理;工業以太網、5G、Wi-Fi 6提供低時延傳輸;時序數據庫(如InfluxDB)高效寫入高頻數據。
二、數據處理:從原始數據到可用信息
原始數據往往含有噪聲、缺失、格式不一,需經過層層處理:
- 數據清洗:去除重復值、填補缺失值、平滑噪聲(如滑動平均、卡爾曼濾波),剔除異常點。
- 數據集成:將來自不同系統(PLC、MES、ERP)的數據統一到數據中臺或數據湖,解決語義沖突與單位不一致。
- 數據變換與歸約:標準化/歸一化、離散化、特征編碼;通過主成分分析(PCA)降維,保留關鍵信息。
- 數據存儲與管理:采用時序數據庫存儲傳感器數據,關系數據庫存儲業務數據,數據湖(如Hadoop、Delta Lake)存儲原始與半結構化數據。建立數據字典與元數據管理,確保可追溯。
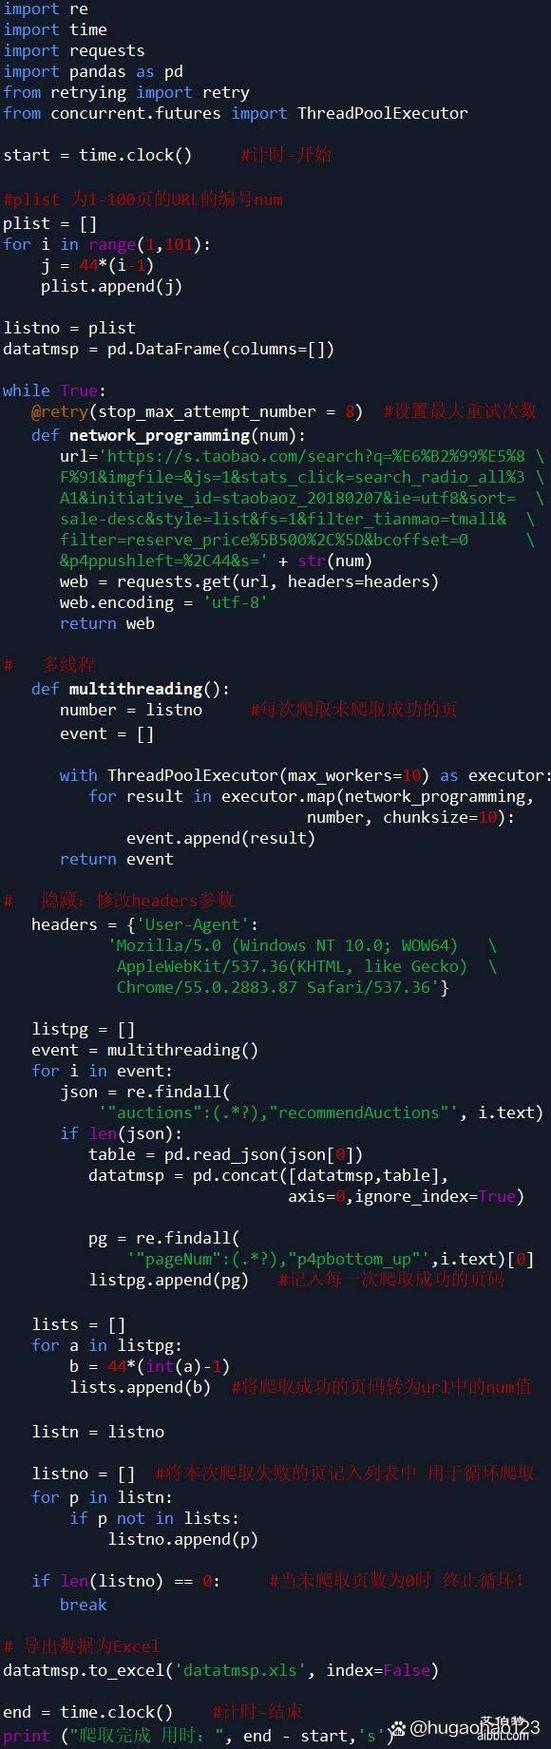
- 實時流處理:利用Flink、Spark Streaming對產線數據流進行窗口聚合、模式檢測,支持實時監控與報警。
三、數據挖掘:從數據中提煉智慧
數據挖掘在數字化工廠中貫穿多個層面:
3.1 描述性挖掘——理解現狀
- 關聯規則:發現工藝參數與缺陷的關聯(如“溫度>80℃且壓力<0.5MPa → 次品率升高”)。
- 聚類分析:對設備工況聚類,識別不同運行模式;對產品質量分群。
- 可視化:通過Dashboard、數字孿生呈現產線狀態。
3.2 預測性挖掘——預見未來
- 分類與回歸:預測設備故障(隨機森林、XGBoost)、預測產品質量(神經網絡)。
- 時間序列預測:預測訂單需求、能耗趨勢(ARIMA、LSTM)。
- 異常檢測:基于孤立森林、自編碼器識別設備異常與質量波動。
3.3 指導性挖掘——優化決策
- 優化算法:遺傳算法、強化學習用于排產調度、工藝參數尋優。
- 根因分析:結合貝葉斯網絡、決策樹定位缺陷根源。
- 數字孿生仿真:在虛擬環境中測試不同策略,將最優解反饋至物理產線。
典型應用場景:
- 預測性維護:減少非計劃停機30%以上。
- 質量預警:提前攔截批量缺陷,降低廢品率。
- 能耗優化:通過挖掘能耗模式,節能5%-15%。
四、挑戰與趨勢
挑戰:數據孤島、數據質量差、實時性要求高、安全與隱私、復合人才短缺。
趨勢:
- 邊緣智能:在設備端直接運行輕量級挖掘模型。
- 自動機器學習(AutoML):降低數據挖掘門檻。
- 聯邦學習:在保護隱私的前提下跨工廠聯合建模。
- 大語言模型:輔助生成數據報告、交互式查詢。
##
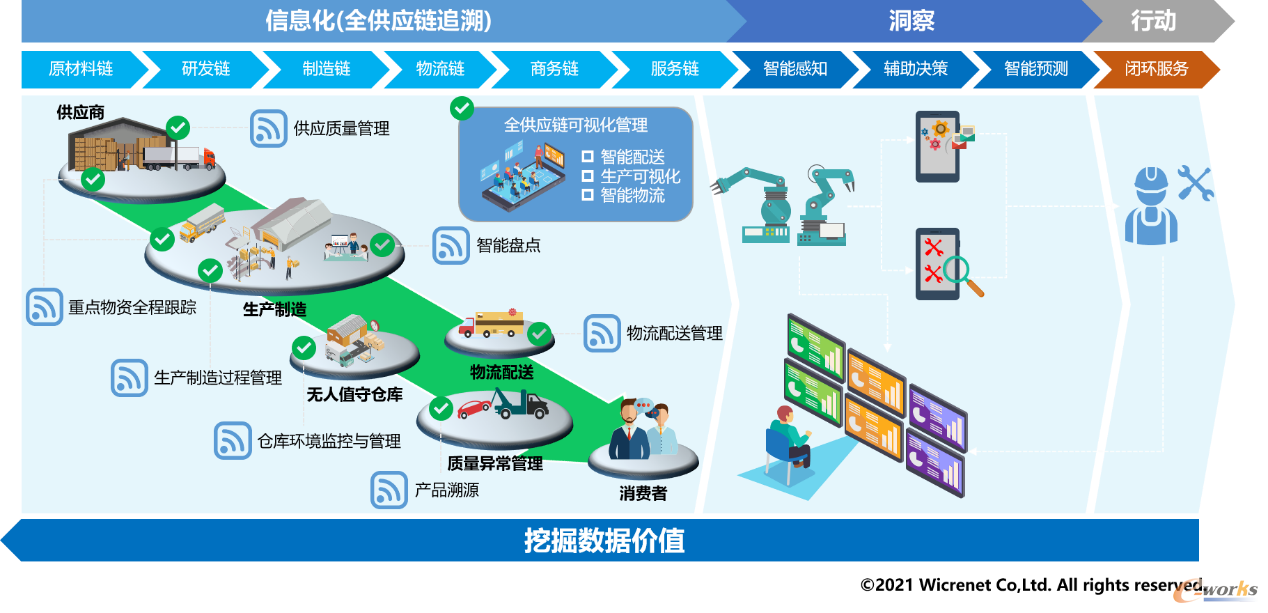
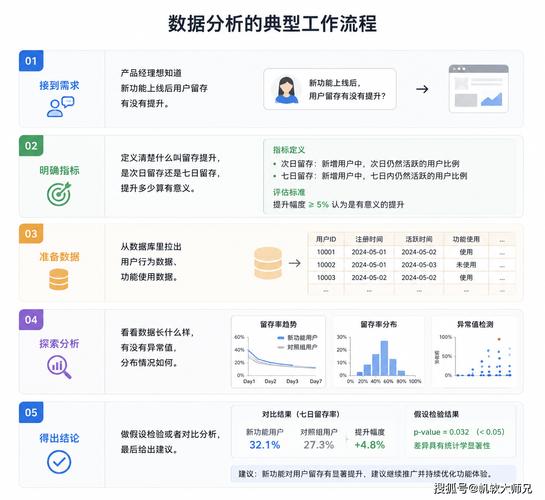
數字化工廠的數據收集、處理與挖掘是一個閉環:傳感器感知物理世界,數據處理提煉信息,數據挖掘生成模型與洞察,再反饋至物理系統優化運行。只有打通這一鏈條,才能讓數據真正成為工廠的“智慧大腦”。
(本文約1500字,涵蓋技術流程與落地應用,可根據具體行業調整案例。)
如若轉載,請注明出處:http://www.jcdez.com.cn/product/43.html
更新時間:2026-10-22 20:58:41