利用Python爬蟲爬取淘寶商品做數(shù)據(jù)挖掘分析實戰(zhàn)篇超詳細教程
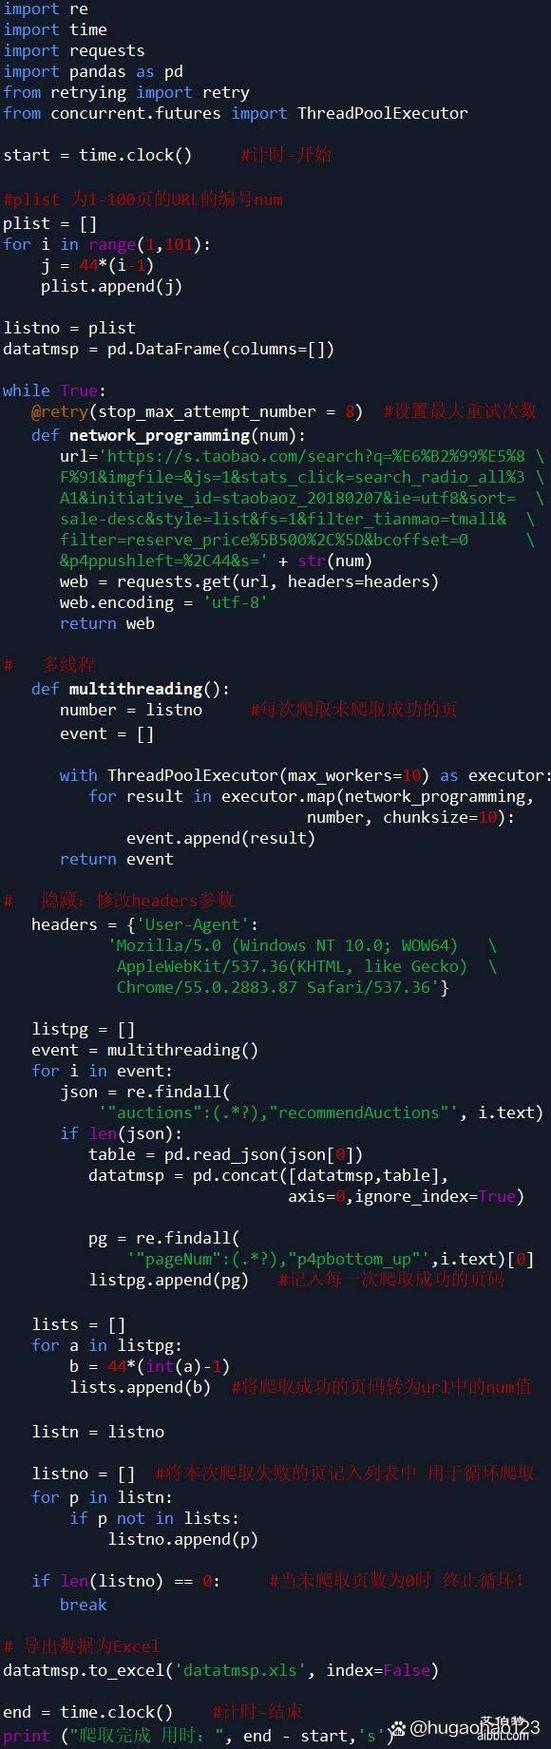
一、前言\n\n在電商競爭日益激烈的今天,獲取商品數(shù)據(jù)并進行分析是每個運營和數(shù)據(jù)分析師的必備技能。本教程將手把手教你如何合規(guī)、高效地爬取淘寶商品數(shù)據(jù),并進行數(shù)據(jù)挖掘分析,探索價格分布、銷量趨勢、用戶評價等有價值的信息。請注意,本教程僅用于學習交流,請務必遵守淘寶robots協(xié)議及相關法律法規(guī),避免對目標網(wǎng)站造成壓力。\n\n目標:\n1. 掌握使用Selenium + BeautifulSoup/Requests爬取淘寶搜索結果頁的方法(應對動態(tài)加載和登錄限制)。\n2. 清洗與存儲爬取到的商品數(shù)據(jù)(標題、價格、銷量、店鋪、地區(qū)等)。\n3. 利用Pandas、Matplotlib、WordCloud等庫進行數(shù)據(jù)挖掘與可視化分析。\n\n## 二、環(huán)境準備\n\n### 2.1 安裝必要庫\n\n`bash\npip install selenium beautifulsoup4 requests pandas matplotlib jieba wordcloud openpyxl\n`\n\n### 2.2 下載ChromeDriver\n\n根據(jù)你的Chrome瀏覽器版本,下載對應版本的ChromeDriver,并放入系統(tǒng)PATH或指定路徑。\n\n## 三、爬取淘寶商品數(shù)據(jù)\n\n### 3.1 分析頁面加載方式\n\n淘寶搜索頁面(如https://s.taobao.com/search?q=關鍵詞)的商品數(shù)據(jù)是動態(tài)加載的。直接使用requests抓取會因為沒有登錄而跳轉(zhuǎn)到登錄頁,且返回內(nèi)容不全。因此我們采用Selenium模擬瀏覽器操作,并手動掃碼登錄(一次登錄可長期保存Cookie)。\n\n### 3.2 完整爬蟲代碼示例\n\n`python\nimport time\nimport random\nimport csv\nfrom selenium import webdriver\nfrom selenium.webdriver.common.by import By\nfrom selenium.webdriver.support.ui import WebDriverWait\nfrom selenium.webdriver.support import expectedconditions as EC\nfrom bs4 import BeautifulSoup\n\n# 配置Chrome選項\noptions = webdriver.ChromeOptions()\noptions.addargument('--disable-blink-features=AutomationControlled')\noptions.addexperimentaloption('excludeSwitches', ['enable-automation'])\noptions.addexperimentaloption('useAutomationExtension', False)\noptions.addargument('user-agent=Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36')\n\ndriver = webdriver.Chrome(options=options)\ndriver.executecdp_cmd('Page.addScriptToEvaluateOnNewDocument', {\n 'source': 'Object.defineProperty(navigator, \
如若轉(zhuǎn)載,請注明出處:http://www.jcdez.com.cn/product/51.html
更新時間:2026-10-22 03:24:02