跟我一起數據挖掘(14)--數據整理與數據歸約
在前面的文章中,我們討論了數據預處理的重要性以及一些基本步驟,如數據清洗和數據集成。今天,我們將繼續深入探討數據預處理中的兩個關鍵環節:數據整理(Data Transformation)和數據歸約(Data Reduction)。這兩個步驟對于提高數據挖掘算法的效率和效果至關重要。
一、數據整理
數據整理,也稱為數據變換,是指將數據從一種格式或結構轉換為另一種更適合挖掘的形式。常見的數據整理方法包括:
- 平滑(Smoothing):去除數據中的噪聲。例如,可以使用分箱(binning)、聚類或回歸等方法進行平滑。
- 聚集(Aggregation):對數據進行匯總或聚合操作。例如,將每日銷售額匯總為每月銷售額。
- 數據泛化(Generalization):將低層次或原始數據替換為高層次概念。例如,將年齡的具體數值映射到“青年”、“中年”、“老年”等類別。
- 規范化(Normalization):將數據按比例縮放,使之落入一個特定的區間,如[0,1]。常見的規范化方法有最小-最大規范化、z-score規范化和小數定標規范化。
- 屬性構造(Attribute Construction):根據現有屬性構造新的屬性,以幫助挖掘過程。例如,根據“出生日期”計算“年齡”。
數據整理的目的是使數據更適應挖掘任務的需求,提高挖掘模型的質量。
二、數據歸約
數據歸約是指在不丟失重要信息的前提下,減少數據量的技術。數據歸約可以提高數據挖掘的效率,降低存儲和計算成本。常見的數據歸約方法包括:
- 維歸約(Dimensionality Reduction):減少屬性(特征)的數量。主要方法有:
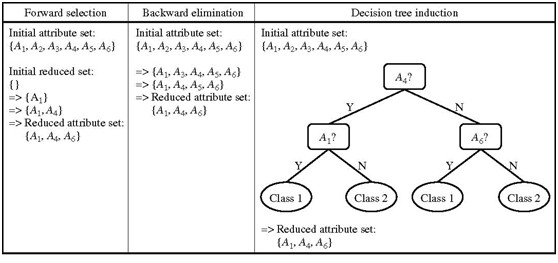
- 特征選擇:選擇最重要的特征子集,剔除不相關或冗余的特征。
- 特征提取:將原始特征空間映射到更低維的空間,如主成分分析(PCA)、因子分析等。
- 數量歸約(Numerosity Reduction):減少數據元組的數量。主要方法有:
- 參數方法:如回歸模型和對數線性模型,只存儲模型參數而不是實際數據。
- 非參數方法:如直方圖、聚類、抽樣等。
- 數據壓縮(Data Compression):使用編碼技術壓縮數據。分為無損壓縮和有損壓縮。
數據歸約的目標是在保持數據完整性的盡量減小數據規模,從而提升數據挖掘的效率和可擴展性。
三、數據整理與歸約的實踐建議
- 理解數據:在進行任何整理或歸約之前,務必深入理解數據的含義和分布。
- 選擇合適的方法:根據挖掘任務和數據特點選擇適當的方法。例如,對于高維數據,維歸約是必要的;對于數據量巨大的情況,數量歸約更為重要。
- 評估效果:整理和歸約后,需要評估其對挖掘結果的影響,確保沒有丟失關鍵信息。
- 迭代優化:數據預處理是一個迭代過程,可能需要多次嘗試和調整。
四、
數據整理和數據歸約是數據挖掘中不可或缺的步驟。它們能夠幫助我們獲得更干凈、更緊湊、更利于挖掘的數據。在實際應用中,我們需要根據具體問題和數據特征,靈活運用各種技術,以達到最佳效果。
希望這篇文章能幫助你更好地理解數據整理與歸約的概念和方法。在下一篇文章中,我們將探討數據預處理的另一個重要方面:數據離散化和概念分層。敬請期待!
如若轉載,請注明出處:http://www.jcdez.com.cn/product/44.html
更新時間:2026-10-22 02:47:53